编程语言基础
键值
封装一组无序号的数据。
通过本节课,你将理解:
#goal目录柜按名字打开抽屉
#hook耶鲁大学斯特林纪念图书馆的卡片目录,不是按「从上往下第几个抽屉」来用的。你拿出对得上的那张卡片:书名、作者、分类号。身份写在键上;位置只是存放的后果。
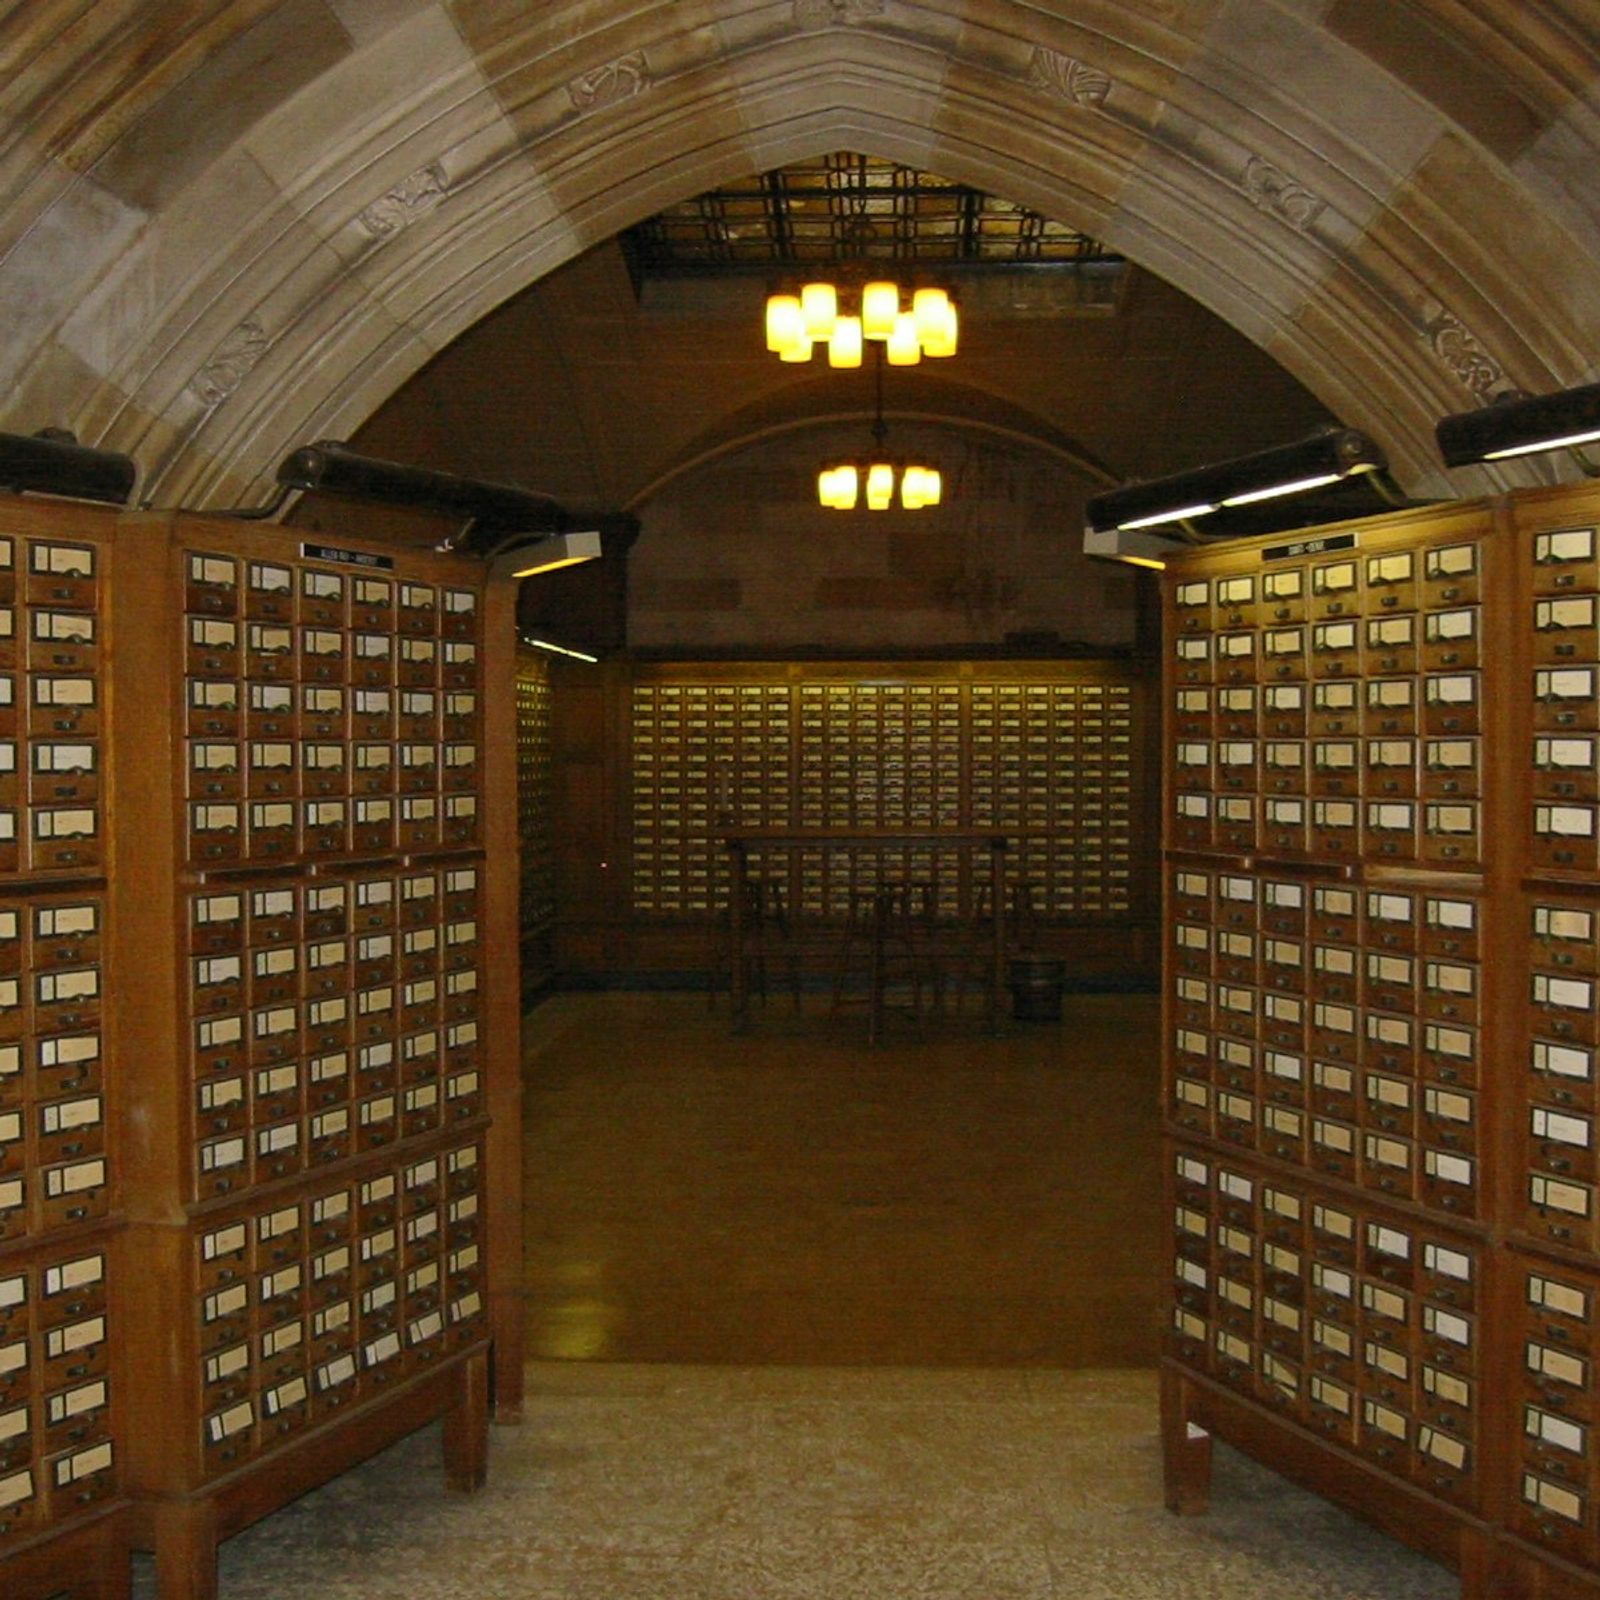
若馆员把新书一律插进第 6 个抽屉,后面所有「第几个抽屉」的口诀全部作废。按书名检索则不然:新卡片进入目录,旧卡片的名字仍然指向原来的那本书。
计算里的字典继承的正是这套目录思想——不是更快的列表,而是另一种提问方式。"C" 比「第 6 格」更难数错——前提是键不重复。同一个键写两次,后面的值覆盖前面的:目录里不能有两张互相打架的「碳」。
字典:键到值的对应
#explore-dict花括号里写成键对值。键是身份,值是与身份绑定的事实。
atomic = {"H": 1, "He": 2, "C": 6}
print(atomic["C"])
print("O" in atomic)
print(atomic.keys())
atomic["C"] 按键取值。键不存在时引发 KeyError:你问了一个目录里没有的名字。in 只检查键,不检查值——"C" in atomic 为真,6 in atomic 为假。
给新键赋值即可添加一对:atomic["O"] = 8。碳仍然是 6。新名字进入目录,旧名字不必重新排队。
atomic["N"] = 7
for symbol, number in atomic.items():
    print(symbol, number)
空字典写成一对空花括号;空集合必须写 set(),因为那对空花括号已经被字典占用。
集合:只关心成员关系
#explore-set集合也用花括号,但没有冒号,只是一堆元素。重复只留一份,也没有下标。打印出来的顺序不必等于书写顺序:集合保证的是在不在,不是排列。
sample = {"C", "H", "O", "H", "C"}
print(sample)
print("N" in sample)
若问题是「出现过哪些不同的元素」,去重不是丢失,而是换了一种提问。若问题其实是「碳被测到几次」,集合会把次数吞掉——那是选错了结构。
两组之间的运算与韦恩图一致:
a = {"C", "H", "O"}
b = {"H", "N", "O"}
print(a & b)
print(a | b)
print(a - b)
& 是交集,| 是并集,- 是差集。
按下标、按名字,还是问在不在
#explore-contrast选结构时先问数据的身份是什么:
| 你真正想问的 | 更合适的结构 |
|---|---|
| 第 3 次测量是多少?顺序要保留,允许重复 | 列表 |
| 碳的原子序数是多少?用符号当名字 | 字典 |
| 两种样品共用哪些元素?只要唯一成员 | 集合 |
| 一个点的两个坐标,不许改写 | 上一课的元组 |
in 用在列表上表示「这个值出现过没有」,用在字典上表示「这个键出现过没有」。同一运算符,询问的对象不同。
若把原子序数硬塞进列表,规定第 0 格是氢、第 1 格是氦,一旦中间插入一种元素,后面所有下标全部错位。按名字检索,插入新键不会掀翻旧键。
本节练习:卫星与两个观测夜
#practice在 在线 IDE 里建立字典:地球 → 1,火星 → 2,木星 → 95。按名字打印火星的卫星数,应为 2;用 in 判断「金星」是不是键,应为假。再设第一夜见到的天体为木星、土星、火星,第二夜为火星、金星,打印交集,应为只有火星。
本节要点
#review- 字典按名字取值;
in检查的是键。键是身份,值是与身份绑定的事实。 - 集合去重、无下标;交、并、差对应成员关系上的运算。它回答「在不在」,不回答「第几个」或「几次」。
- 列表按位置,字典按名字,集合按在不在。一对空花括号是空字典,空集合写
set()。 - 检索方式决定能提出什么样的问题;选错结构,等于选错了问题。
单选题
按键取出
字典里键 C 对应 6。按键 C 取出的结果是?
单选题
in 检查的是键
字典里键 H 对应 1、键 C 对应 6。表达式「6 是否在字典里」的值是?
单选题
集合的交集
集合 a 含 1、2、3,集合 b 含 2、3、4。a 与 b 的交集是?
单选题
目录还是座次
若把原子序数放进列表,规定第 0 格氢、第 1 格氦,中途插入一种新元素,主要会发生什么?
单选题
空花括号
一对空花括号在 Python 里默认表示什么?
未登录时不会保存学习进度